层次聚类算法

对聚类算法有一点点入门的时候就知道,几乎所有的“平面型”聚类算法都有一个共同的弱点-难以确定类别数(聚类停止条件),而层次聚类在一定程度上解决了这个问题(它算一种比较古老比较通用的聚类算法吧)。谈到层次这个词,很容易想象到聚类的过程是线性分阶段进行的。

1. 层次聚类两种基本方法:凝聚的和分裂的

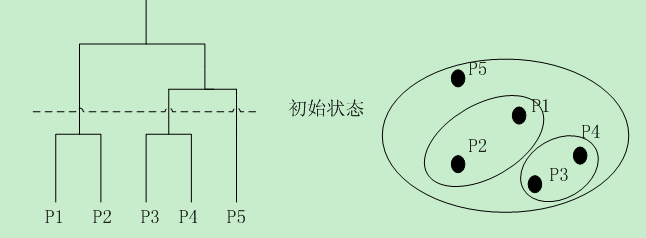
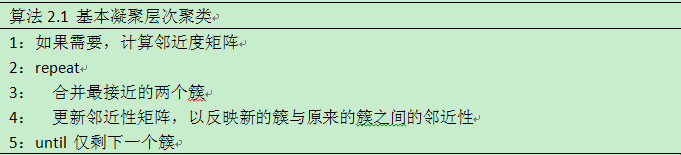
  • 凝聚的:从点作为个体簇开始,每一步合并两个最接近的簇。这里需要定义簇的邻近性概念,如图所示。
层次聚类算法

  • 分裂的:从包含所有点的某个簇开始,每一步分裂一个簇,直到仅剩下单个点簇。这种情况比较复杂,我们需要确定每一步分裂哪个簇,以及如何分裂。
层次聚类算法

2. 常用的基于凝聚的层次聚类

下面探讨两个问题:

1) 定义簇之间的邻近性(需要注意的是两个点的距离可以根据自己的需要去定义,这里说的是如何根据簇内多个点与其他点或者簇计算两个簇之间的邻近性)

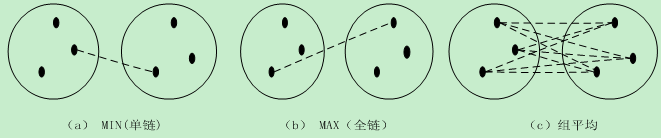
源于簇的基于图的术语,有MIN、MAX、和组平均三种方法。MIN定义簇之间的邻近度为不同簇的两个最近的点之间的邻近度(图的术语表示:不同的结点子集中两个结点之间的最短边)。MAX取不同簇中两个最远的点之间的邻近度。通常我们使用单链(single link)和全链(complete link)来分别表示这两种方法。组平均定义簇邻近度为取不同簇的所用点对邻近度的平均值(平均变长)。三种方法如图所示。
层次聚类算法

当然,簇也可用质心代表,这样邻近度的定义为质心之间的距离就更加自然。还有一种方法Ward,该方法试图最小化点到其簇质心的距离的平方和。

2) 时间和空间复杂性

需要存储m2/2个邻近度,其中m是数据点的个数。因此空间复杂度为O(m2)。

需要O(m2)时间计算邻近度矩阵,之后步骤3和4涉及m-1次迭代,如果某个簇到其他所有簇的距离存放在一个有序表或堆中,则查找两个最近簇的开销可能为O(m-i+1).总时间为O(m2logm)。

3. 问题及优缺点

层次聚类的主要问题主要包括

1) 缺乏全局目标函数,使用各种标准在每一步局部地确定哪些簇应当合并,成功避开了解决困难的组合优化问题。但是这样的方法没有局部极小问题或很难选择初始点。

2) 处理不同大小簇的能力,若想平等地对待不同大小的簇,必须赋予不同簇中的点不同的权值。

3) 合并决策是不可逆的,一旦做出决策,就不能撤销了。

优点与缺点:

比较适合那些需要层次结构的应用,通常情况下,层次聚类会产生较高质量的聚类结果并可以根据邻近度阈值等相关指标确定聚类个数。然而计算量和存储代价是昂贵的,高维数据可能会出现较大问题。由于是不可逆的,对于噪声比较敏感。有些研究先使用其他聚类算法进行部分聚类,然后利用之前聚好的簇再进行层次聚类往往可以解决上述问题。


张晗

2015.1.28

原创文章,作者:admin,如若转载,请注明出处:https://www.isclab.org.cn/2015/01/28/%e5%b1%82%e6%ac%a1%e8%81%9a%e7%b1%bb%e7%ae%97%e6%b3%95/

(2)
adminadmin
上一篇 2015年1月28日
下一篇 2015年1月28日

相关推荐

  • 面向网络应用程序的模糊测试

    本报告介绍了模糊测试中的基本概念及网络应用程序漏洞挖掘发展历史和类型划分等背景知识,对2种基于覆盖引导的灰盒web模糊测试算法进行了具体说明,阐述了网络应用程序漏洞挖掘的发展趋势和…

    2024年5月31日
    3.0K
  • 内部威胁检测方法

    近年来,内部(insider)攻击,包括组织信息系统破坏、信息盗窃、电子欺诈等,具有很强的隐蔽性和破坏性,对个人、企业和国家安全构成了巨大的威胁。因此,我们应该更加关注内部威胁的研…

    2021年10月27日
    3.5K
  • 高斯混合模型及求解算法

          高斯混合模型(Gaussian mixture model,GMM)用于对样本的概率密度分布进行估计,而估计…

    2019年2月18日
    3.1K
  • Bias-Variance trade-off

    背景 熟悉模式识别的童鞋都很清楚,在模式识别领域内存在许多的学习算法和技术。面对纷繁的算法,我们必然会产生疑问:究竟哪一个算法才是“最好的”。值的强调的是每个算法都有相应的先验假设…

    2016年1月21日
    3.9K
  • 显式周期引导的长时序列预测

    该研究提出显式周期引导的长期时间序列预测方法,核心包括Periodformer和CycleNet两种模型。Periodformer通过周期注意力机制显式捕捉长期周期性模式,降低计算…

    2025年11月3日
    3.2K
  • 文本生成中的幻觉

    本次报告讲解了文本生成中的幻觉问题。首先从文本生成的基本原理出发引入到幻觉问题,着重介绍了幻觉的概念、产生原因以及解决方法。然后从添加外部信息和幻觉数据处理两个角度入手分别介绍了K…

    2023年8月20日
    3.4K
  • 自动化程序缺陷修复及其应用研究

    大型复杂软件系统的高频率开发迭代,导致潜在缺陷数量增加,影响工业控制、交通管理等关键领域正常运转。缺陷修复指生成软件缺陷的修复代码,降低人工成本。研究自动化缺陷修复,能够及时修复软…

    2024年8月18日
    3.2K
  • 缓解多模态大语言模型的幻觉问题

    该研究针对多模态大语言模型生成内容与输入信息不符的“幻觉”问题,提出两种缓解方法:OPERA在推理阶段通过惩罚过信任与回溯重分配机制减少幻觉;HACL在训练阶段引入幻觉文本作为困难…

    2025年12月1日
    5.3K
  • 如何优雅地阅读和复用代码

    面对大型软件项目,如何准确、快速地找到目标代码的位置将会极大地加速我们的二次开发。本次报告以GUI程序为例介绍了软件源码查找、修改和使用的一般流程。对初学者的软件项目开发工作大有裨…

    2020年1月2日
    3.6K
  • 联邦学习的参数更新方法

    联邦学习在为解决数据交换时的信息隐私安全及数据孤岛问题时被提出,现广泛应用的为横向联邦与纵向联邦,本次学术报告介绍了联邦学习的基本思路,并基于横向联邦说明了两种经典的参数更新和合并…

    2021年10月11日
    4.1K